Wer Entwürfe aus Künstlicher Intelligenz (KI) nachprüfen lässt, sollte wissen, was sein Werkzeug nicht findet
Zwei Klassen von Prüfprogrammen, dieselbe Aufgabe: Beim Rechnen sind sie sich einig. Beim Fehlenden gehen sie weit auseinander.
Andreas Ehstand ·
Für wen das wichtig ist
In Behörden, Schulen und Büros schreiben Computerprogramme inzwischen Entwürfe: Bescheide, Angebote, Berichte, Zusammenfassungen von Verträgen. Meist gilt dieselbe Vorgabe dazu — die Ausgabe wird noch einmal nachgeprüft, oft mit einem zweiten Programm und am Ende von einem geschulten Prüfer, also jemandem, der für genau diese Kontrolle ausgebildet ist. Wer diese Nachkontrolle einrichtet, steht vor einer sehr praktischen Frage: Wonach soll eigentlich gesucht werden — und worauf kann man sich beim Werkzeug verlassen?
Wir haben das gemessen, und zwar mit zwei ganz verschiedenen Klassen von Prüfprogrammen an derselben Aufgabe.
Was gemessen wurde
Grundlage ist eine Sammlung deutschsprachiger Verwaltungs- und Bürotexte mit absichtlich eingebauten Fehlern: falsche Summen und Prozentwerte, falsche Fristen, frei erfundene Regeln, Sätze, die der eigenen Zahl im selben Absatz widersprechen — und fehlende Angaben: etwas, das im Ausgangsmaterial steht und in der geprüften Ausgabe schlicht nicht mehr vorkommt. Die Sammlung enthält außerdem Stellen und ganze Aufgaben ohne Fehler — nur dadurch lässt sich zählen, wie oft ein Programm etwas Richtiges fälschlich anstreicht.
Dieselbe, absichtlich schwer gebaute Fassung bekamen zwei Klassen vorgelegt: fünf günstige Sprachmodelle — also Computerprogramme, die Texte lesen und selbst schreiben können — und vier aktuelle Spitzenmodelle von vier verschiedenen Anbietern.
Das Ergebnis in zwei Sätzen
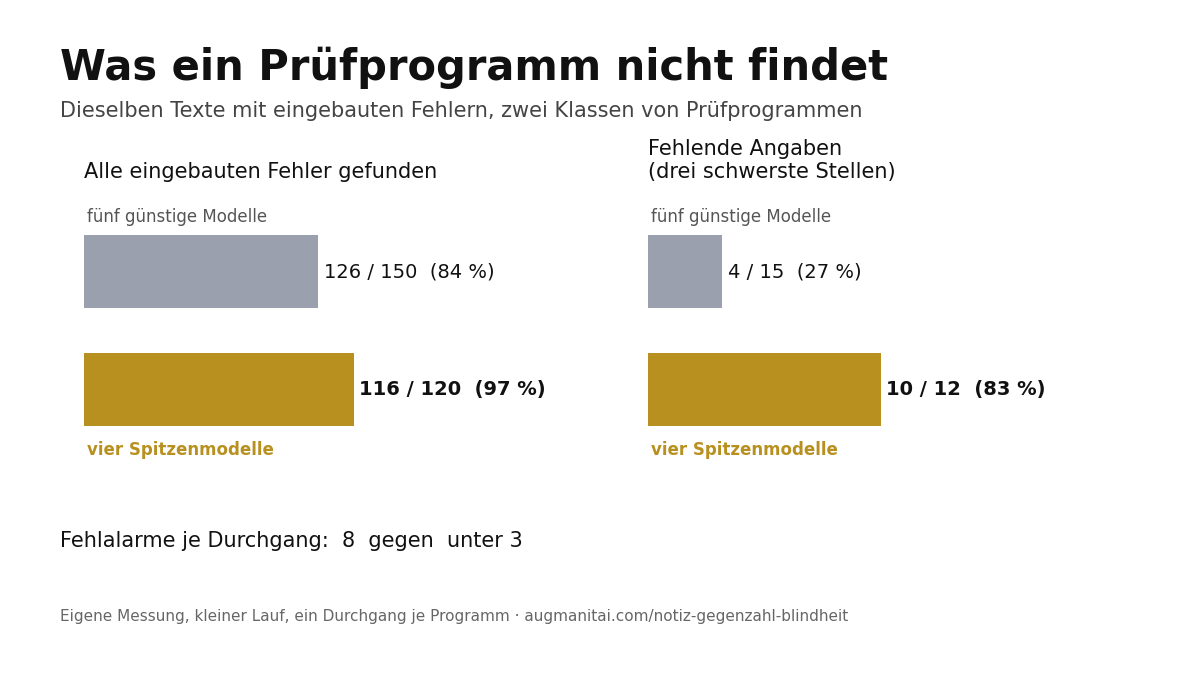
Beide Klassen sind als Vorsortierer brauchbar: Die günstigen fanden 126 von 150 eingebauten Fehlern, die starken 116 von 120 — 84,0 gegen 96,7 Prozent, und keine einzige Antwort fiel aus. Der Unterschied zwischen den Klassen liegt nicht in der Gesamtzahl, sondern in einer einzigen Fehlerart — und ausgerechnet in der teuersten.
Wo die Unterschiede sitzen
Steht im Text eine Zahl, gegen die man rechnen kann, findet praktisch jedes Programm den Fehler: eine Summe, die nicht aufgeht; ein Prozentwert, der nicht stimmt; ein Satz, der der eigenen Zahl im selben Absatz widerspricht. Es gibt einen Anker, an dem man ziehen kann.
Fehlt dagegen etwas, gibt es nichts zum Gegenrechnen — die fehlende Frist oder Bedingung muss aus dem Ausgangsmaterial herangetragen werden. Genau hier trennen sich die Klassen:
- An den drei Stellen, die den günstigen Programmen am schwersten fielen, fanden sie den Fehler in 4 von 15 Gelegenheiten. Die starken Programme kamen an denselben drei Stellen auf 10 von 12.
Ein zweiter, unabhängiger Durchlauf mit sechs Spitzenmodellen bestätigte das Bild: An denselben zwei Stellen blieb bei vier von sechs Programmen mindestens eine Angabe liegen.
Die zweite Zahl gehört zwingend dazu: die Fehlalarme, also Stellen, an denen etwas Richtiges als Fehler markiert wurde. Auch da liegen die Klassen auseinander — im Schnitt acht Fehlalarme je Durchgang gegen knapp drei, und an den fehlerfreien Aufgaben stand die starke Klasse bei null. Ein Werkzeug, das vorsichtshalber alles anstreicht, findet ebenfalls alles und ist trotzdem wertlos. Eine Trefferquote ohne Fehlalarm-Zahl ist keine Aussage.
Der Satz, auf den sich das Ganze bringen lässt
Fehlende Angaben — Bedingungen, die in der geprüften Ausgabe gar nicht vorkommen — sind die Fehlerart, bei der sich Prüfprogramme am stärksten unterscheiden: stärkere Programme finden sie weitgehend, schwächere lassen sie regelmäßig liegen. Für das Muster bei den schwächeren Programmen gibt es einen Namen: Gegenzahl-Blindheit.
Warum das praktisch teuer ist
Im Verwaltungs- und Büroalltag ist genau das die teure Hälfte. Eine falsche Summe fällt spätestens bei der nächsten Rechnung auf. Eine Bedingung, die nie im Text stand, fällt niemandem auf — bis jemand sie einfordert.
Dazu kommt ein zweites Problem, das größer ist als das erste: Von außen sieht kaum ein Büro, welches Modell in seinem Werkzeug arbeitet. Die Oberfläche ist dieselbe, der Ton ist gleich zuversichtlich, und auch bei den günstigen Werkzeugen liegt der Preis je geprüftem Dokument nicht höher. Wer nur das Etikett „KI-geprüft" liest, weiß nicht, ob sein Werkzeug das Fehlende findet oder nicht.
Warum der geschulte Prüfer dadurch nicht überflüssig wird
Er wird nicht überflüssig — seine Aufgabe wird schärfer. Weil man dem Etikett nicht ansehen kann, wie gut das Werkzeug bei fehlenden Angaben ist, braucht die Nachkontrolle zwei feste Fragen, die immer gleich lauten:
- Was steht im Ausgangsmaterial, das in der Ausgabe fehlt?
- Welche Meldungen der Maschine sind gar keine Fehler?
Die erste Frage deckt genau die Lücke ab, die schwächere Werkzeuge offen lassen. Die zweite spart die meiste Zeit: Angestrichenes zurückzuweisen geht schneller, als selbst zu suchen. Eine Nachkontrolle ist dann kein zweites Lesen mehr, sondern eine gezielte Suche — der Unterschied zwischen einer Kontrolle, die Zeit kostet, und einer, die Geld spart.
Was ein Büro morgen tun kann
Zwei Schritte, beide klein:
-
Dem Etikett nicht glauben
„Mit Künstlicher Intelligenz geprüft" sagt nichts darüber, ob das Werkzeug fehlende Angaben findet.
-
Das eigene Werkzeug an einer bekannten Aufgabe messen
Einen eigenen Vorgang nehmen, selbst Fehler einbauen — darunter mindestens eine Bedingung, die man aus der Ausgabe herausgenommen hat — und das Werkzeug darüberlaufen lassen. Was es in diesem Durchgang findet, ist ein erster Anhaltspunkt - für andere Fälle folgt daraus keine Garantie. Was es liegen lässt, bleibt die Aufgabe des geschulten Prüfers.
Einordnung: Ein Durchgang je Programm, angelegt als Anfang und nicht als Urteil über einzelne Werkzeuge. Eine unabhängige, nachbaubare Vergleichsverteilung — also eine Zahlenreihe, die jemand von außen mit denselben Schritten noch einmal erzeugen könnte — gibt es für diese Frage bisher nicht. Genau die soll entstehen.
Diese Notiz ist Teil 1 der Reihe Übersehene Momente zwischen Mensch und KI — elf Teile, alle vollständig auf einer Seite.
Andreas Ehstand, Augmanitai